Branche
Mit einem Programm Werk, Depot und Zentrale erreichen, ohne so zu tun, als wären sie gleich.
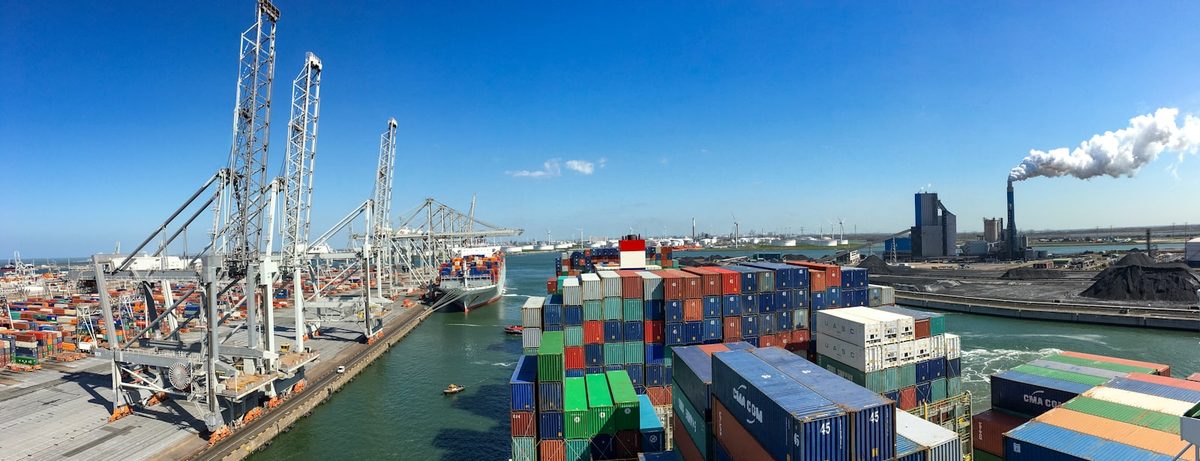
In Industrie, Energie und Logistik sind die Daten operativ, bevor sie analytisch werden. Sensorwerte, Wartungsprotokolle, Lastprofile, Routen- und Lieferdaten, Sicherheitsmeldungen. Davon gibt es reichlich, oft eingeschlossen in Systemen, die nie dafür gebaut wurden, miteinander zu sprechen, und die Menschen, die ihnen am nächsten sind, haben selten die Dashboards.
Daraus entsteht eine bestimmte Lücke. Die Zentrale baut Modelle und Berichte; Werk, Depot und Außenteams haben den Kontext, der diese Modelle richtig machen würde, und keine gemeinsame Sprache, um ihn zu übergeben. Ein Programm, das nur die Analysten schult, vergrößert diese Lücke, statt sie zu schließen.
Dazu kommt die Streuung: mehrere Betriebsgesellschaften, mehrere Länder, Schichtmodelle, die einen Schulungsraum unmöglich machen, und Tausende Kolleginnen und Kollegen, die gar nicht am Schreibtisch arbeiten. Und eine Sicherheitskultur, die zu Recht fragt, was passiert, wenn ein Modell falsch liegt, weshalb KI-Arbeit hier von Anfang an mit Governance ankommen muss.
Das Verhalten, um das es geht, sitzt in der Halle, nicht in der Zentrale: ein Operator, der versteht, was ein Modell meldet, und es laut sagt, wenn das nicht zu dem passt, was er hört. Diese eine Gewohnheit macht aus einer Analytics-Investition etwas, das funktioniert, und genau sie baut ein Pilot in der Zentrale nie auf.
Dafür braucht es Wissen darüber, wie die Daten entstanden sind und was sie weglassen, Können in den Tools, die die Leute schon haben, geübt im Browser statt angeschaut, und eine gemeinsame Sprache zwischen Werk, Depot und Analysten, damit Kontext tatsächlich übergeben wird. Wo eine Kundenorganisation eine eigene KI-Richtlinie hat, geht diese Richtlinie ins Programm ein, damit das Gelernte und das Erlaubte dasselbe sind.
Die Verankerung über Standorte und Schichten hinweg ist der schwierige Teil. Champions pro Standort, Live-Sessions, die sich um Schichtmodelle herum legen, und eine Übergabe an Ihr eigenes L&D, damit die Community das Programm überlebt. Den Zuwachs messen wir gegen eine Ausgangsmessung vor dem Start und vergleichen ihn mit anderen Organisationen.
Die SHV Energy Data & AI School ist unsere bislang größte Partnerschaft. Sie startete im Sommer 2026 und erreicht bis zu 6.000 Mitarbeitende in Ländern wie den Niederlanden, Italien und Brasilien, wobei die eigene KI-Richtlinie von SHV Energy im Programm steckt statt danebenzustehen.
Bei PostNL haben wir Effective Prompting for Everyone gestartet, ausgerollt an 4.000 Kolleginnen und Kollegen, die praxisnah mit KI arbeiten und lernen, sie in ihrer täglichen Rolle einzusetzen.
Es hilft auch, dass wir schon auf Ihrer Seite des Tisches gesessen haben. Unser Mitgründer Nanne Veldman hat Jahre in einem globalen Energiekonzern gearbeitet, bevor er Data Booster mitgegründet hat, und deshalb ist dieses Programm um Betriebsgesellschaften, Standorte und Schichtmodelle herum gebaut statt um einen einzelnen Piloten in der Zentrale.
Abschlussquote
in den letzten zwölf Monaten
Teilnehmende
haben unsere Programme durchlaufen
Durchschnittliches Kompetenzwachstum
Vor und nach dem Programm gemessen, nie selbst eingeschätzt
Die Branche zeigt, wie der Beleg aussieht. Die Persona zeigt, was jede Gruppe tatsächlich lernt.

Mitglied bei
Nominiert